多序列比对
星比对
算法实现思路
- 在序列中选择一个中心序列
,中心序列的选择算法,在下文详细阐述 - 将中心序列
和其余序列进行双序列比对,得到 个双序列比对 - 将k-1个双序列比对进行整合,整合原则“once a gap, always a gap”
例子
以下为自拟教学示例,三张图使用同一组输入。采用全局比对,匹配得分为
S1 ACGT
S2 AGT
S3 ACGTT- 计算两两最优比对得分,选择与其余序列的得分之和最大的序列作为中心序列。这里最大化的是相似性得分;若改用距离,选择方向需要相应改变。
图 1:总分为与其余序列的得分之和,对角线不计入总分。S1 的总分为
- 将中心序列与其余序列做比对。
图 2:上方为 S1 与 S2 的比对,得分 4;下方为 S1 与 S3 的比对,得分 6。蓝绿色始终表示中心 S1,浅色格表示空位。S1 与 S3 存在并列最优排列,图中选择在 S1 的末端插入空位的一种。
- 将双序列比对整合到一起,得到MSA。
图 3:① 保留 S1、S2 的已有比对;② 将 S1 与 S3 比对引入的末端空位同步补入已有两行,橙色列表示新增位置;③ 加入 S3。S2 在 C 对应位置的原有空位保留。最终各行等长,去掉空位后分别恢复原始输入;它们组成一个中心星比对结果,不据此声称达到了所有可能多序列比对的全局最优值。
多核并行
由上文可知,建立得分矩阵选取中心序列是非常耗时的。因此在建立得分矩阵的这个环节,我们可以采取多核并行,加快程序的运行速度。由实际的运行速度来看,并行计算要比单核运行快3.6倍左右(根据电脑的核心数有关,测试电脑的核心数是4核)。
内存优化
针对大型数据集,不能一次将数据读入内存,采取分批次的读取,能有效降低内存的使用。内存消耗由双序列比对和块的大小决定,块最小为一条序列,最大为输入文件的大小。
树比对
算法实现思路
- 建立序列间的距离矩阵,常见的算法有k-tuple、fasta和动态规划等
- 使用聚类算法,生成指导树,常见的算法有 Neighbor Joining (NJ)、UPGMA等
- 沿着指导树的顺序进行比对
例子
下面是独立的四序列示例,与上一节三序列例子的编号分别使用。
S1 ATTGCCATT
S2 ATGGCCATT
S3 ATCTTCTT
S4 ACTGACC- 指导树用于安排合并顺序。下面沿用一个示意拓扑来说明操作,不由图中枝长读取距离。
图 4:节点数字表示合并顺序,对应下文的三次操作。枝长只服务于排版,不代表进化距离;本例没有提供用于推导该拓扑的距离矩阵。
- 沿着指导树的顺序进行比对
合并S1和S3
    S1:AT-TGCCATT

    S3:ATCTTC--TT
合并(S1,S3)和S2
    S1:AT-TGCCATT
    S3:ATCTTC--TT

    S2:AT-GGCCATT
合并(S1,S3,S2)和S4
    S1:AT-TGCCATT
    S3:ATCTTC--TT
    S2:AT-GGCCATT

    S4:ACTGACC---
比对完成
    S1:AT-TGCCATT
    S2:AT-GGCCATT
    S3:ATCTTC--TT
    S4:ACTGACC---
偏序图比对 (Partial Order Multiple Sequence Alignment, PO-MSA/POA)
多序列的有向无环图表示
在 POA 中,首先将每个序列的每个碱基/氨基酸视为一个结点。其次,为了进一步简化 MSA 的表示形式,将原始 MSA 同一列相同/相匹配的结点合并表示。最后,依照节点之间的位置(偏序)关系生成有向边,形成有向无环图(DAG)。
将下述两条序列利用 DAG 表示:
CCGCTTTTCCGC
CCGCAAAACCGC
两条序列共享前缀与后缀 CCGC,中间分别为 TTTT 和 AAAA。
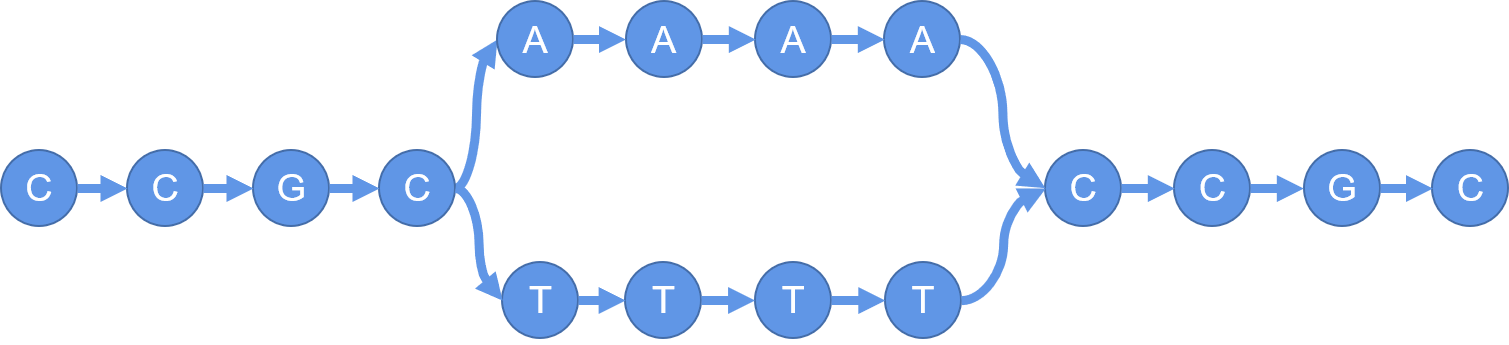
图 5:保留原图,每个圆形节点表示一个碱基。沿箭头从左向右读取,上分支为 CCGCAAAACCGC,下分支为 CCGCTTTTCCGC。
基于 POA 求解多序列比对并生成共识序列
共识序列指对于一个 MSA,可以代表 MSA 的大部分性质的序列。在中心星比对中,选取的中心序列被视作共识序列。在 POA 中,为了能更好地代表 MSA,需要生成一条序列作为共识序列。
算法实现思路
- 对于每条序列,利用动态规划与 DAG 进行比对,并合并到 DAG 上
- 比对完成后,将 DAG 转换成多序列比对结果
- 依据 DAG 的权重,通过最重束(heaviest bundle)求解最大似然路径。最大似然路径上的点构成共识序列
DAG 与序列的比对
与双序列比对相似,序列与 DAG 的比对可以用动态规划求解;差别在于图节点可能有多个前驱,需要比较来自每个前驱的候选。下面用线性空位罚分
为区分原图中两个碱基为 T 的节点,下文将中间的 T 称为 AAGGC,当前字符是第 3 个字符
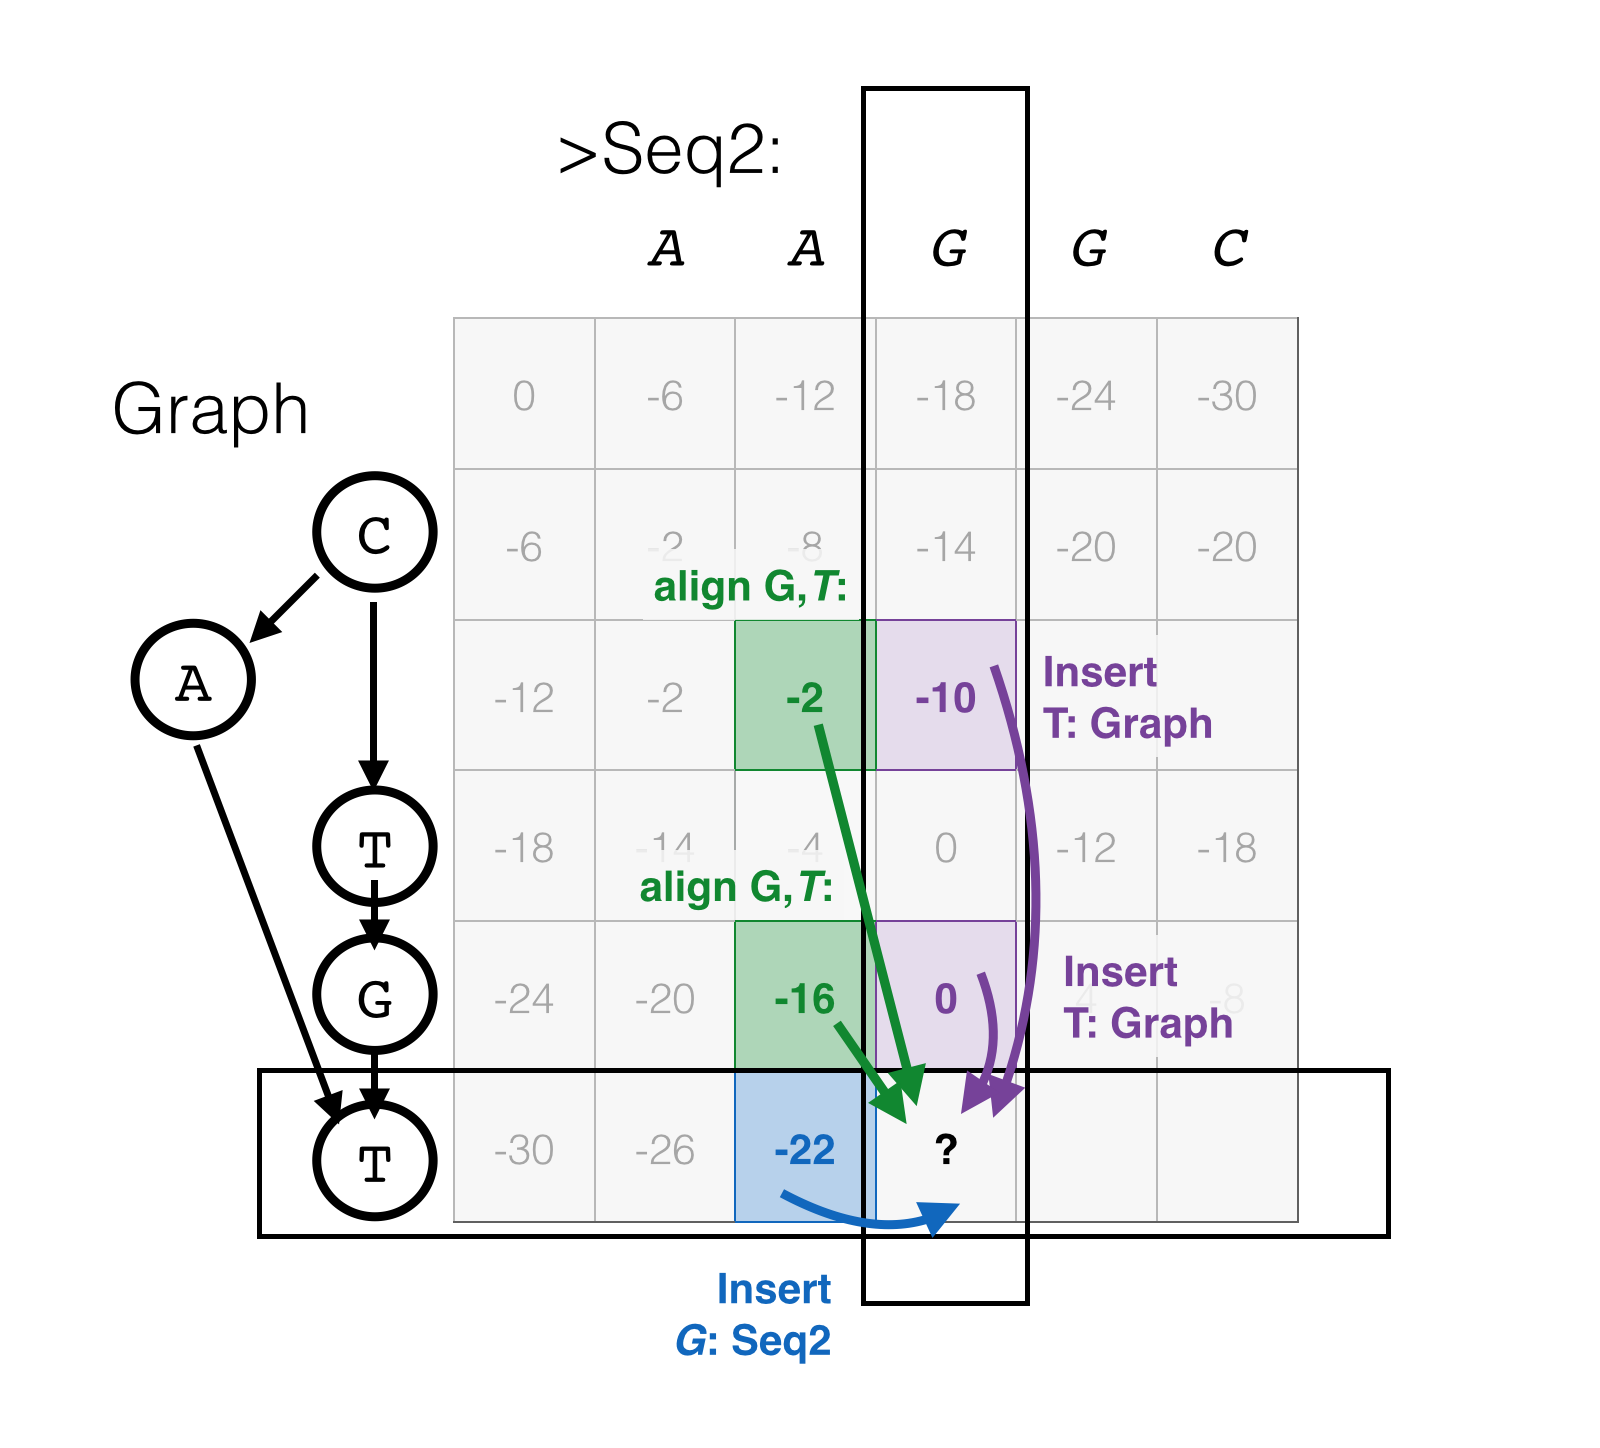
图 6:保留原图。绿色箭头表示字符配对,紫色表示图上前进、序列配空位,蓝色表示序列前进、图配空位;前两类都需比较 A、G 两个前驱。图中数值沿用旧图,其完整评分约定未提供,因此这里只用它说明依赖关系,不将数字作为可复核算例。完整计算还需初始化边界并沿图的拓扑顺序更新。POA 原始论文、abPOA 官方实现。
方法实现
前人实现了 K-band + SIMD 优化的偏序图比对:
Ref: Gao, Y., Liu, Y., Ma, Y., Liu, B., Wang, Y., & Xing, Y. (2021). abPOA: an SIMD-based C library for fast partial order alignment using adaptive band. Bioinformatics, 37(15), 2209-2211.